在全球GPU竞争白热化的背景下,英伟达凭借其硬件优势与CUDA软件生态构筑了难以逾越的护城河。国内一批未上市的GPU初创公司正试图从不同路径突围,对标“中国英伟达”。本文聚焦九家代表性企业(壁仞科技、摩尔线程、燧原科技、天数智芯、沐曦集成、象帝先、格兰菲、芯动科技、兆芯),重点剖析它们在软件开发层面的战略布局与挑战。
一、通用图形与计算双赛道:摩尔线程与壁仞科技
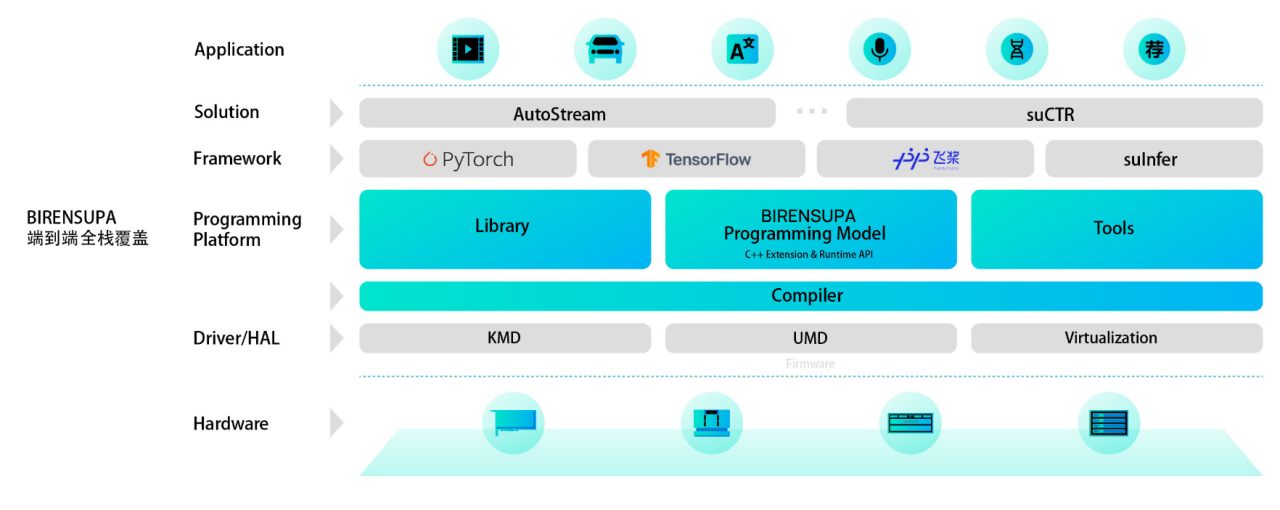
摩尔线程走全功能GPU路线,其MUSA统一系统架构兼容CUDA代码迁移,提供musify工具链,并开源了Torch-MUSA等插件,试图降低开发者迁移成本。壁仞科技主打通用计算GPGPU,其BIRENSUPA软件平台支持主流深度学习框架,并通过LLVM后端实现算子自动生成,但生态积累尚浅。
二、AI训练推理专用:燧原科技与天数智芯
燧原科技构建了“驭算”软件平台,提供TopsRider编译器和TopsCCL通信库,兼容ONNX/PyTorch,重点优化Transformer类模型推理。天数智芯的Iluvatar CoreX软件栈支持PYNQ框架和自定义算子开发,但其编程模型更依赖手动调优,易用性待提升。
三、异构计算与图形渲染:沐曦集成与象帝先
沐曦集成推出MXMACA软件栈,兼容CUDA风格API,并提供MXSArray自动并行工具,试图在迁移便利性上突破。象帝先聚焦图形渲染GPU,其PHPU软件栈支持OpenGL/Vulkan,在国产CAD/EDA场景中打磨驱动与编译器,但AI计算生态薄弱。
四、老牌IP与芯粒路线:格兰菲、芯动科技与兆芯
格兰菲(与Imagination合作)主攻图形GPU,其软件以OpenCL/OpenGL驱动为主,AI布局较晚。芯动科技采用Chiplet设计,其“风华”系列GPU搭配InnoGPU软件栈,强调多卡互联与虚拟化。兆芯集成GPU核心(源自S3)侧重信创办公,图形驱动通过WHQL认证,计算生态依赖第三方移植。
五、软件开发的关键挑战与突围策略
- 兼容CUDA vs 自建生态:多数公司选择兼容CUDA以降低迁移门槛,但长期需构建自主编程模型(如摩尔线程的MUSA)。
- 开源社区建设:通过开源框架插件(如PyTorch集成)吸引开发者,弥补人力不足。
- 工具链易用性:调试器、性能分析器(profiler)的成熟度直接影响开发效率。
- 行业样板案例:与头部AI企业共建联合方案(如燧原与腾讯的合作),通过标杆项目验证软件可靠性。
六、
国内未上市GPU公司的软件生态仍处于“可用”向“好用”过渡的阶段。短期看,兼容CUDA策略能快速切入市场;长期看,唯有在编译器优化、分布式通信库、开发者社区上持续投入,方能在细分领域站稳脚跟。真正的“中国英伟达”不仅需要硬件参数,更需要软件的灵魂。